


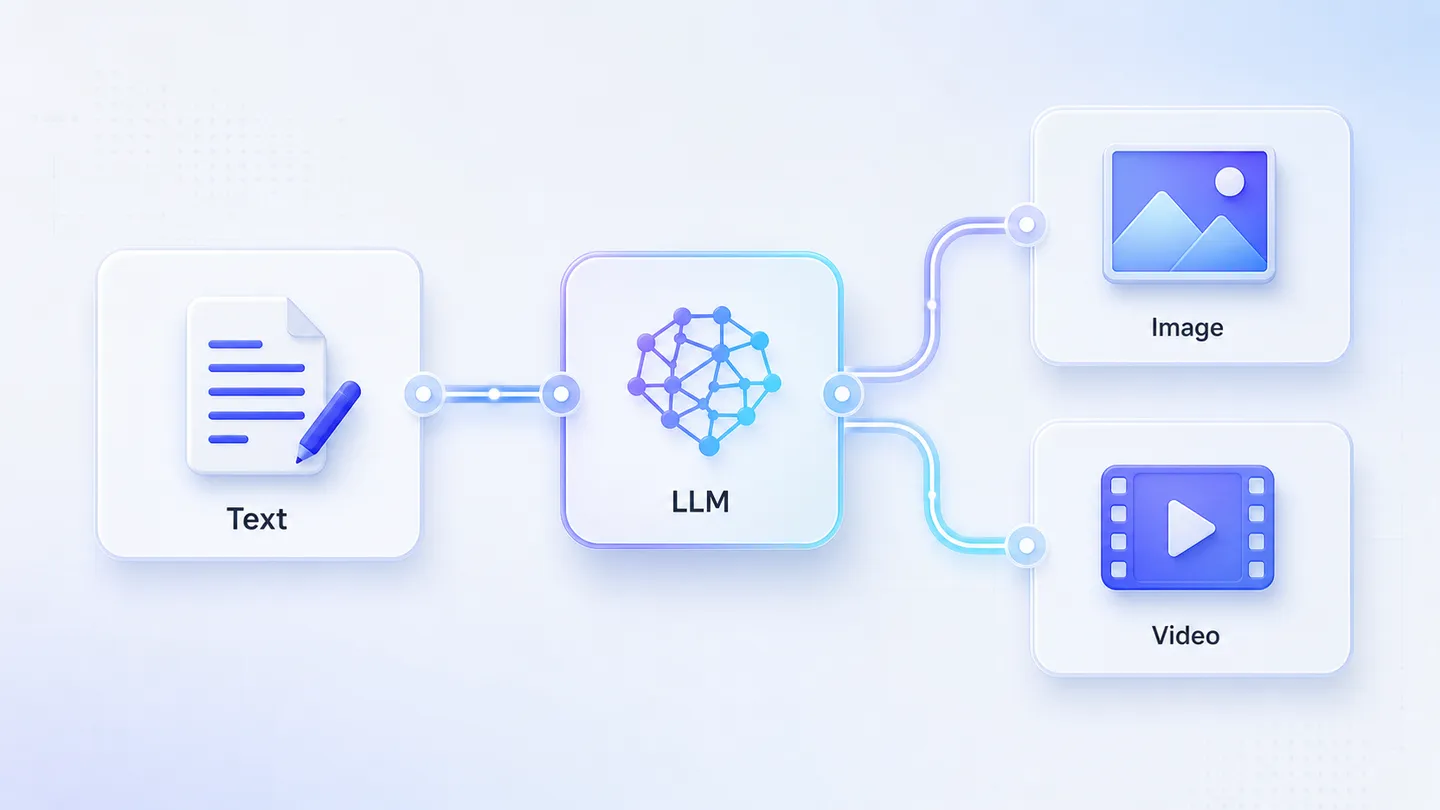
LLM ステップが重要な理由
画像および動画モデルは、プロンプトが具体的で構造化され、視覚的である場合に最高のパフォーマンスを発揮します。通常、短いユーザーのアイデアだけでは十分ではありません。
RelayMe ワークフローでは、LLM ノードがプロンプト ライターとして機能します。これにより、通常のリクエストが、ダウンストリーム メディア モデルが使用できる本番環境に対応したプロンプトに変換されます。
基本的なチェーンを構築する
最初に Text ノードを作成します。ユーザーはここに、生のアイデア、商品の説明、スクリプト、またはキャンペーンの方向性を書きます。
その Text ノードを LLM ノードに接続します。LLM 命令では、被写体、シーン、カメラ、照明、スタイル、制約、出力形式を使用して入力を視覚的なプロンプトに書き換えるように依頼します。
次に、LLM 出力を画像ノードまたは動画ノードのプロンプト フィールドに接続します。メディア モデルは、元のラフ テキストではなく、LLM によって生成されたプロンプトを読み取る必要があります。
商品固有の入力とレビュー手順については、商品画像ワークフローに進みます。
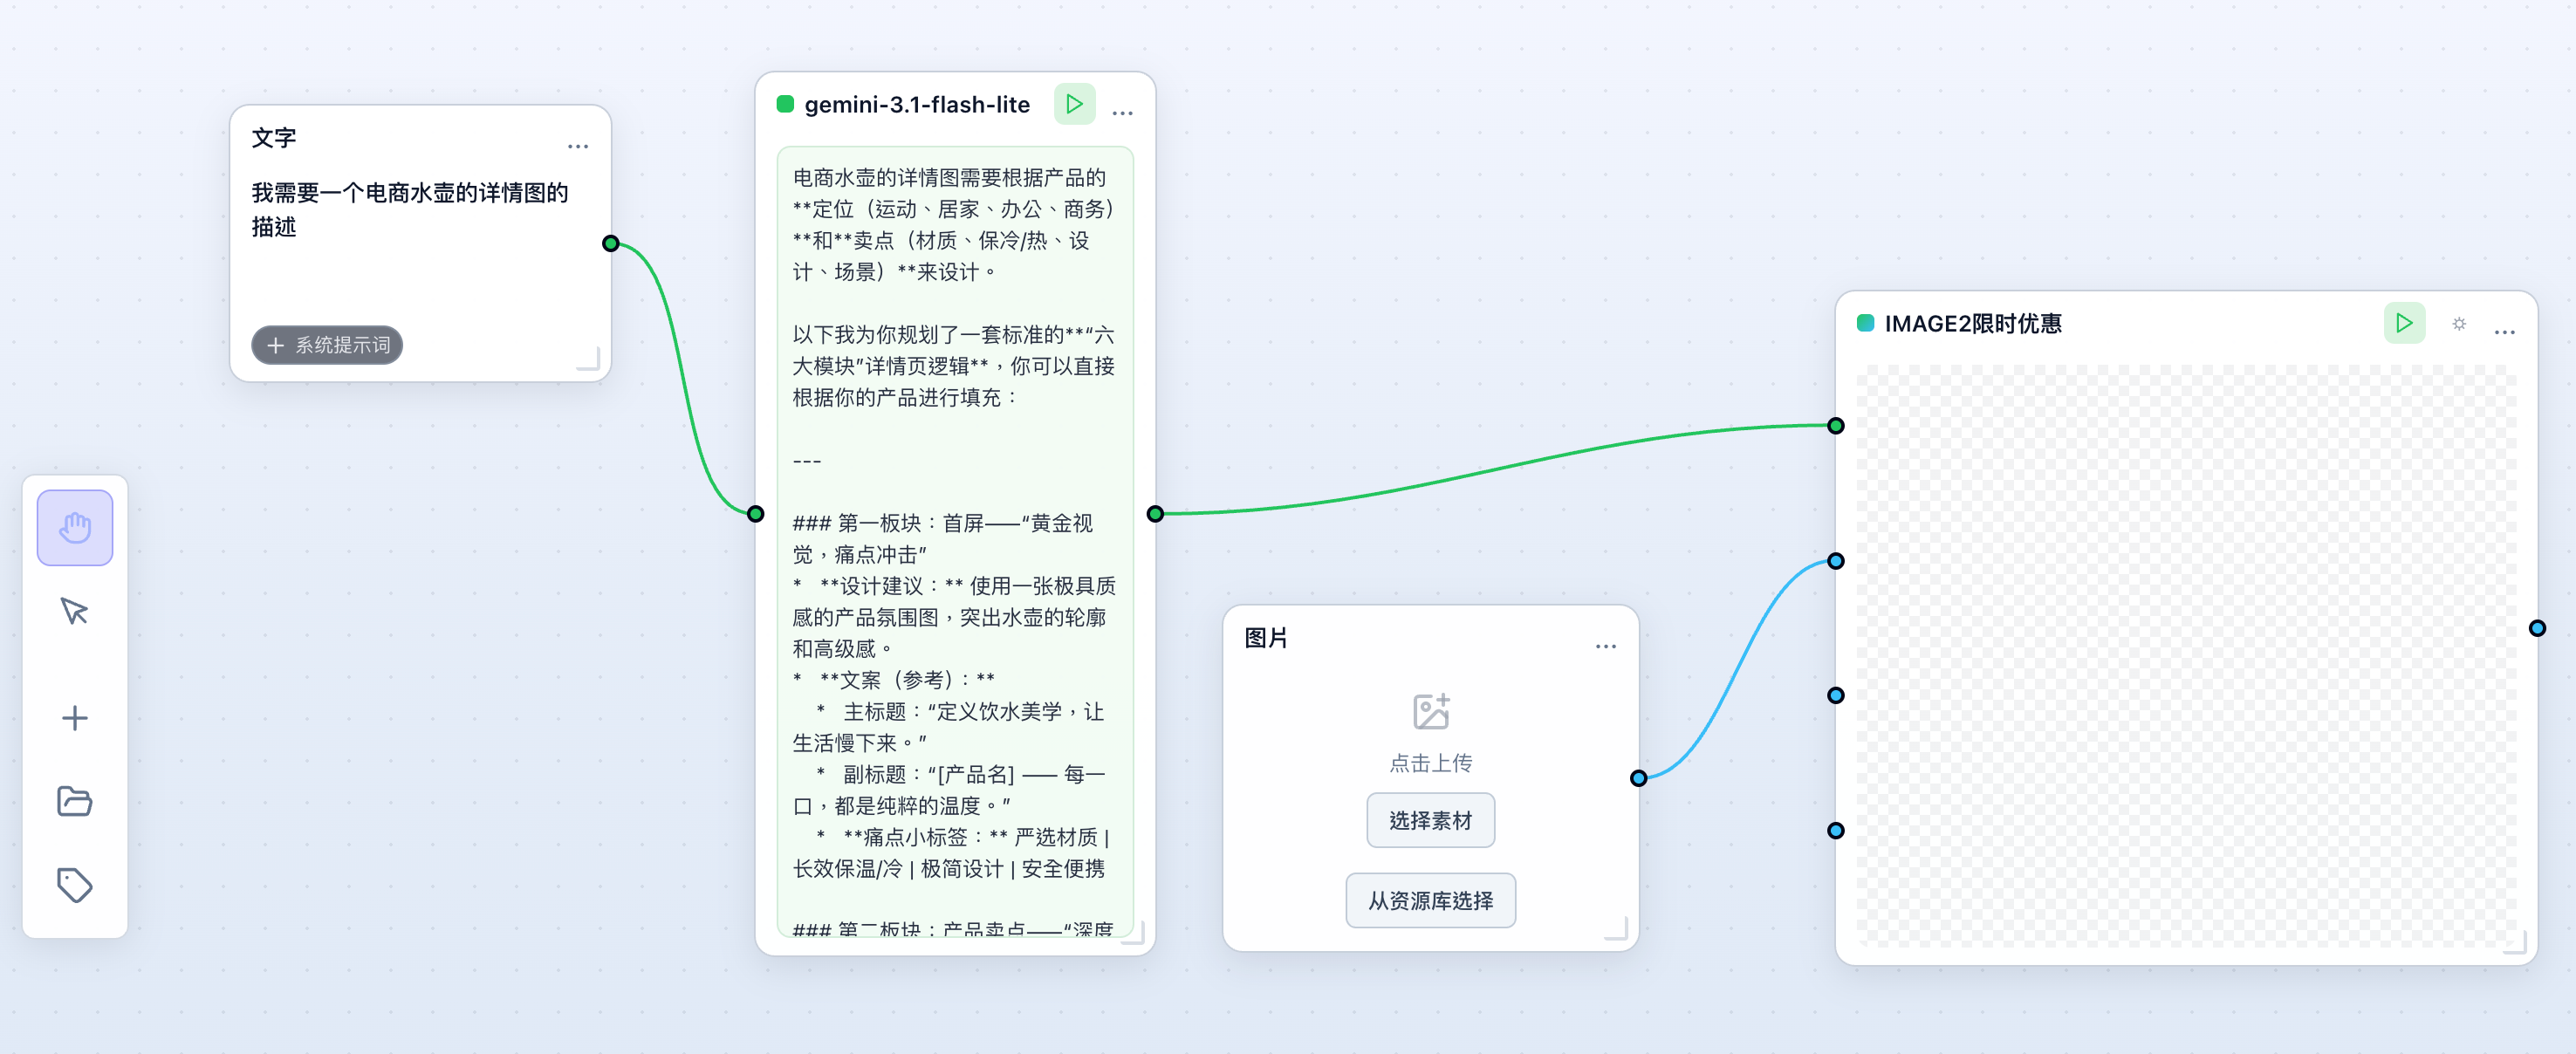
1 つのアイデアを画像と動画に分岐させます
LLM 出力が安定したら、それを複数の生成ノードに分岐できます。
たとえば、同じ構造化されたビジュアル プロンプトをポスター コンセプトの場合は画像ノードに送信し、短いモーション バージョンの場合は動画ノードに送信します。必要に応じて、動画の前に 2 番目の LLM ノードを追加して、プロンプトをショットごとの言語に書き換えます。
実践的なLLM命令
次のような指示を使用します。ユーザー入力を明確な画像または動画生成プロンプトに書き換えます。被写体、環境、ビジュアル スタイル、カメラ アングル、照明、雰囲気、構図、否定的な制約が含まれます。最後のプロンプトのみを返します。
これにより、ワークフローが予測可能になり、異なる商品、スクリプト、またはクリエイティブ ブリーフに対して同じテンプレートを再利用しやすくなります。
静止画像が承認されると、画像から動画へのガイドで次の段階とその日付付きの作業例が説明されます。